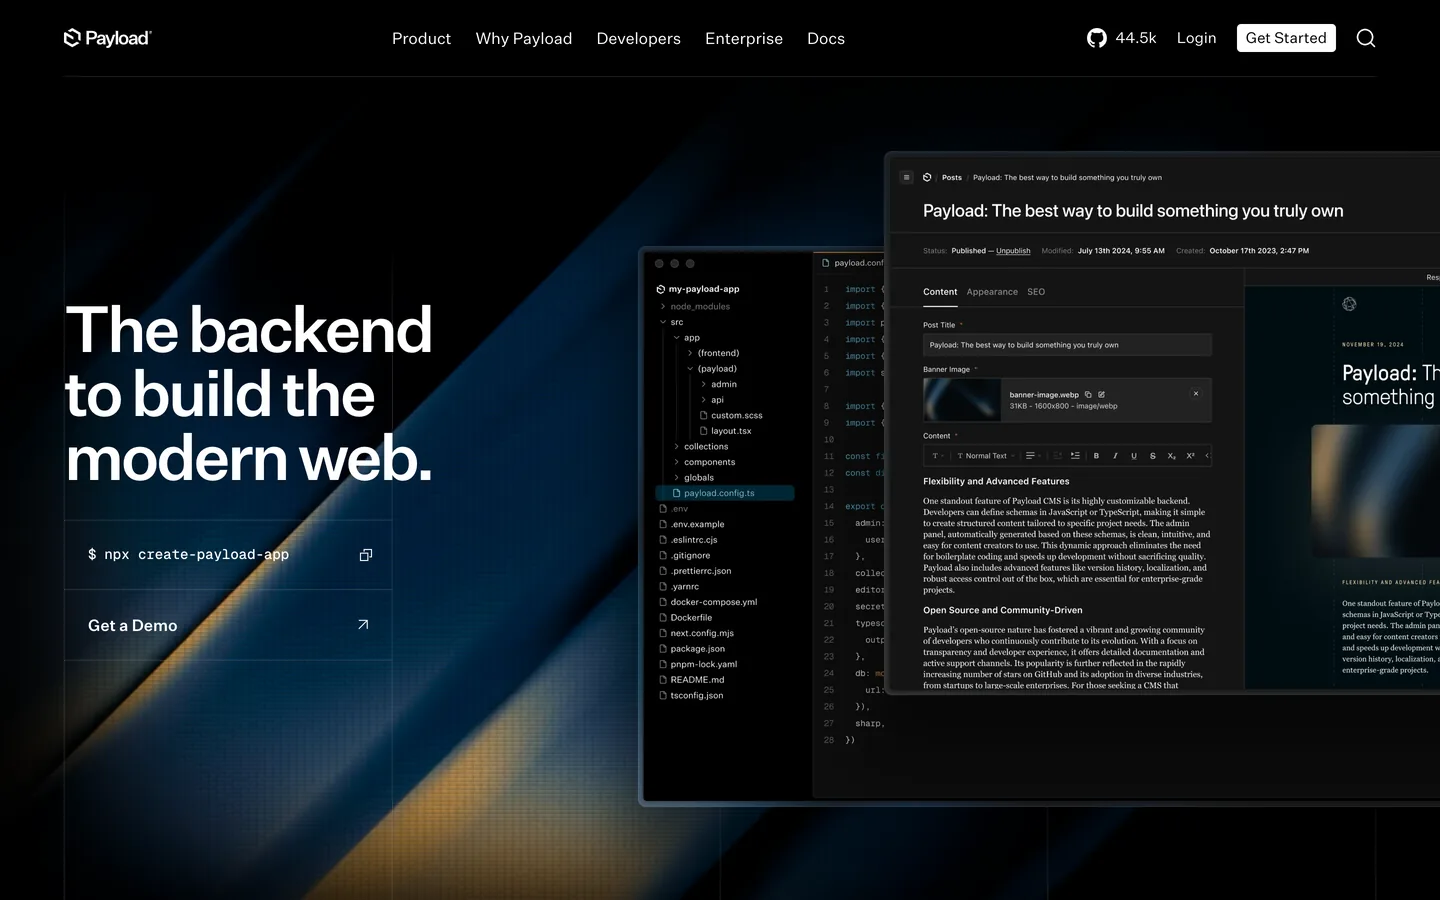
Chcesz, aby Twoja strona na Payload CMS pojawiała się w odpowiedziach AI, a nie tylko wśród klasycznych dziesięciu niebieskich linków? Payload CMS to headless CMS w TypeScripcie, w podejściu „najpierw kod” (code-first), który hostujesz samodzielnie obok swojej aplikacji. Redaktorzy pracują w nim z kolekcjami i globalnymi zbiorami zdefiniowanymi jako typowane pola, a programiści czytają i zapisują treści przez REST, GraphQL oraz lokalne API po stronie serwera. Ten sterowany schematem rdzeń czyni go mocną podstawą do optymalizacji pod silniki generatywne (GEO). Zacznij od bazowego audytu geo seo i pozwól, by każdy zysk kumulował się w działającym panelu GEO / SEO. Ten poradnik pokazuje, jak zamodelować, wyrenderować i opisać znacznikami Payload, aby Google oraz asystenci, tacy jak ChatGPT, Perplexity, Claude i Gemini, rozumieli i cytowali Twoje podstrony.
Dlaczego GEO na Payload CMS w 2026 roku
Widoczność dzieli się dziś na dwie części: linki w rankingu, o które już walczysz, oraz krótka lista źródeł, które ChatGPT, Perplexity, Claude i Gemini cytują, odpowiadając na pytania. Generative Engine Optimization to praktyka dołączania do tej listy. Payload dobrze się do tego nadaje, ponieważ treść jest zdefiniowana jako kod: każda kolekcja ma typowane pola, walidację i relacje, oparte na MongoDB lub Postgres, więc każdy dokument zachowuje się jak czysty, uporządkowany rekord, a nie dowolna strona. Ponieważ Payload jest headless, renderujesz go przez szybki, nowoczesny frontend i zachowujesz pełną kontrolę nad semantycznym HTML, który modele odczytują jako odrębne encje.
Sprawdź, jak wypadasz w odpowiedziach AI
Najpierw zmierz, potem buduj. Zadaj wiodącym asystentom prawdziwe pytania, które zadaje Twoja grupa docelowa, a następnie zapisz, czy Twoje strony się pojawiają i jakie adresy URL są cytowane. Śledź cytowania marki za pomocą śledzenia wzmianek w AI, analizuj odwołania, które już zdobywasz, dzięki backlinkom cytowanym przez AI, i wykonaj szczegółowy audyt geo seo, by zmapować encje (markę, osoby, produkty) powiązane już z Twoją domeną. Taki punkt odniesienia mówi, które kolekcje i dokumenty zoptymalizować w pierwszej kolejności.
Zmapuj prawdziwe intencje i prompty
W GEO intencja przychodzi w postaci pełnych promptów, a nie ściętych słów kluczowych. Zbierz dokładne sformułowania, jakich ludzie używają w czacie i głosowo, a potem pogrupuj je według zadania: poznać, porównać, wybrać i naprawić. Poszerz pokrycie dzięki narzędziu query fan-out i uszereguj tematy za pomocą badania słów kluczowych. Dla każdego klastra wyznacz jeden kanoniczny dokument Payload jako stronę, którą chcesz być cytowany, a następnie zadbaj, by był zwięzły, nadawał się do cytowania i opierał się na wyraźnych dowodach, tak aby model mógł wyciągnąć fragment bez zniekształcania jego sensu.
Uporządkuj treść za pomocą kolekcji, pól i encji
Potraktuj kolekcje jako szkielet encji. Zdefiniuj kolekcje takie jak Posts, Categories, Products, Team, FAQs i Glossary, nadaj każdej typowane pola i połącz je polami relacji. Zmapuj swoje pola na właściwości schema.org, takie jak name, description, image, datePublished, author, about i sameAs, a metadane SEO przechowuj w osobnej grupie w każdej kolekcji. Ponieważ schemat jest kodem, kanoniczne nazwy i fakty pozostają jednolite w całym serwisie, a oficjalna wtyczka SEO standaryzuje pola tytułu i opisu. Ta powtarzalna głębia to autorytet tematyczny, który silniki odpowiedzi nagradzają przy wyborze źródła.
Wybierz frontend w Next.js dla szybkich, łatwych do crawlowania stron
Payload jest headless, więc połącz go z szybkim frontendem, takim jak Next.js, Nuxt czy Astro, i renderuj strony na serwerze. Payload jest ściśle zintegrowany z Next.js, więc pobierasz dokumenty przez lokalne API w czasie budowania lub żądania i generujesz czysty, semantyczny HTML bez narzutu hydratacji po stronie klienta dla treści. Użyj generowania statycznego lub przyrostowej regeneracji dla artykułów, serwuj zasoby przez CDN i stosuj agresywne buforowanie. Szybkie strony z kodem łatwym do crawlowania zwiększają pokrycie crawlowania i częstotliwość, z jaką asystenci Cię cytują.
Opieraj metadane na polach kolekcji: dodaj oficjalną wtyczkę SEO lub własną grupę SEO, aby każdy dokument miał precyzyjny tytuł, meta description i wartości Open Graph zgodne z treścią. We frontendzie renderuj te pola w nagłówku dokumentu, buduj czyste, bogate w encje adresy URL ze slugów i drukuj znaczniki canonical, aby scalić duplikaty i archiwa z paginacją w jeden adres. Użyj meta robots, by wykluczyć z indeksu ubogie listy tagów i filtrowane widoki, dzięki czemu asystenci odczytują jedno spójne znaczenie na stronę.
Dodaj schemat JSON-LD we właściwy sposób
W Payload JSON-LD żyje we frameworku frontendowym, a nie w panelu administracyjnym. W komponencie strony w Next.js, Nuxt czy Astro wygeneruj blok skryptu typu application/ld+json wypełniony z pobranego dokumentu, tak aby każda strona zawierała dane strukturalne zbudowane z własnych pól. Używaj Article z WebPage i BreadcrumbList dla treści, Product z offers na stronach sprzedażowych, HowTo dla poradników oraz FAQPage dla bloków pytań. Dodaj ogólnoserwisowy graf Organization z logo, contactPoint i linkami sameAs, aby asystenci potwierdzali fakty i wiązali Twoje strony z rozpoznawanymi encjami.
Twórz wyraźne bloki pytań i odpowiedzi, które odzwierciedlają prawdziwe prompty, i dodaj dedykowaną grupę pól FAQ lub pole bloków, aby redaktorzy odtwarzali ten wzorzec w każdym odpowiednim dokumencie. Utrzymuj każdą odpowiedź w granicach od 50 do 120 słów, linkuj do pasującej podstrony wewnętrznej i podaj jedno autorytatywne źródło zewnętrzne. W przypadku procedur przedstaw materiały, uporządkowane kroki i wymagany czas w formie HowTo. Te zwięzłe formaty usuwają niejednoznaczność i ułatwiają asystentowi cytowanie Twoich stron na Payload z zachowaniem sensu.
Pliki prowadzące crawlery: robots.txt, sitemap.xml, llms.txt
Wygeneruj we frontendzie mapę witryny XML z każdym opublikowanym dokumentem, a następnie prześlij ją w Google Search Console. W robots.txt zezwól na trasy z treściami nadającymi się do cytowania i zablokuj panel administracyjny oraz punkty końcowe API. Opublikuj w katalogu głównym domeny plik llms.txt, który określa preferowane reguły crawlowania dla agentów AI, Twoje priorytetowe adresy URL i warunki ponownego wykorzystania treści. Ten plik jest coraz częściej respektowany i jasno wskazuje pochodzenie treści modelom, które cytują źródła.
Linkowanie wewnętrzne, nawigacja i breadcrumbs
Zbuduj huby tematyczne, które gromadzą powiązane dokumenty i definiują Twoje kanoniczne odpowiedzi, a dla czytelnej hierarchii użyj globalnego zbioru nawigacji oraz breadcrumbs. Dodawaj kontekstowe linki w treści z opisowymi anchorami i łącz każdy dokument z jego hubem nadrzędnym oraz tematami pokrewnymi przez pola relacji. Przyspiesz mapowanie dzięki generatorowi klastrów tematycznych. Jeśli części Twojego stosu działają gdzie indziej, zastosuj to samo podejście w Strapi, Directus, Webflow i Shopify.
Sygnały autorytetu: backlinki, wzmianki i E-E-A-T
GEO nadal opiera się na autorytecie. Zdobywaj cytowania z wiarygodnych publikacji, badań pierwotnych oraz społeczności TypeScript i programistów skupionych wokół projektów Payload. Publikuj pod nazwiskami ekspertów, eksponuj kwalifikacje recenzentów oraz prowadź szczegółowe strony biograficzne i stronę „O nas”, które wzmacniają E-E-A-T. Śledź swoją pozycję w czasie za pomocą monitora autorytetu domeny i wyświetlaj wyraźną datę ostatniej aktualizacji przy strategicznych dokumentach, aby zarówno Google, jak i asystenci uznawali Twoje treści za aktualne i zadbane.
Publikuj na dużą skalę z Sorank i Make.com
Payload CMS udostępnia publiczne API: każda kolekcja automatycznie otrzymuje punkty końcowe REST i GraphQL, które tworzą dokumenty, choć nie ma dedykowanej aplikacji w Make.com. Dlatego Sorank łączy się przez most oparty na webhooku Make.com: każdy wygenerowany artykuł trafia do scenariusza Make.com, a Make publikuje go w Payload za pomocą ogólnego modułu HTTP Make.com, wysyłając żądanie POST do punktu końcowego Twojej kolekcji z kluczem API. Natywnego konektora Sorank jeszcze nie ma, a ta droga automatyzuje publikację. Szybko przygotuj zoptymalizowane szkice artykułów dzięki generatorowi artykułów blogowych, a następnie opublikuj je zgodnie z harmonogramem. Najpierw sprawdź wywołanie tworzenia treści na swojej działającej instancji i, jeśli Twoja konfiguracja je ogranicza, skorzystaj z własnego bloga Sorank.
Mierz widoczność w AI i iteruj
Śledź, jakie prompty wywołują Twoją markę, które dokumenty są cytowane i gdzie wygrywają konkurenci. Porównuj się z konkurencją dzięki szpiegowi konkurencji SEO, obserwuj swoją pozycję w rankingu GEO i przypisuj wizyty wywołane przez asystentów za pomocą otagowanych stron docelowych i UTM. Przeglądaj dane po każdym nowym schemacie, klastrze treści i kampanii linkowej, a pętlę powtarzaj co miesiąc, aby GEO stało się mierzalnym, kumulującym się silnikiem wzrostu.
Podsumowanie
Payload CMS daje Ci typowany model treści w podejściu „najpierw kod” oraz pełną kontrolę nad znacznikami frontendu, a GEO dostarcza strategii, by wyświetlić go silnikom odpowiedzi. Gdy Twoje dokumenty jasno eksponują encje, precyzyjne metadane i wiarygodne dowody, asystenci cytują Cię z pewnością. Skonfiguruj uporządkowane kolekcje, szybki frontend renderowany po stronie serwera, JSON-LD oraz odpowiedzi nadające się do cytowania, a potem pozwól Sorank prowadzić audyty, treści i linki, aby Twoja marka stała się źródłem, które modele wolą cytować w 2026 roku i później.