
Налаштування
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Зробіть свій сайт на Payload CMS видимим для Google і пошуку на основі ШІ. Використовуйте колекції, поля, фронтенд на Next.js, JSON-LD та llms.txt, щоб ChatGPT, Perplexity, Claude і Gemini цитували ваші сторінки.





Інструменти


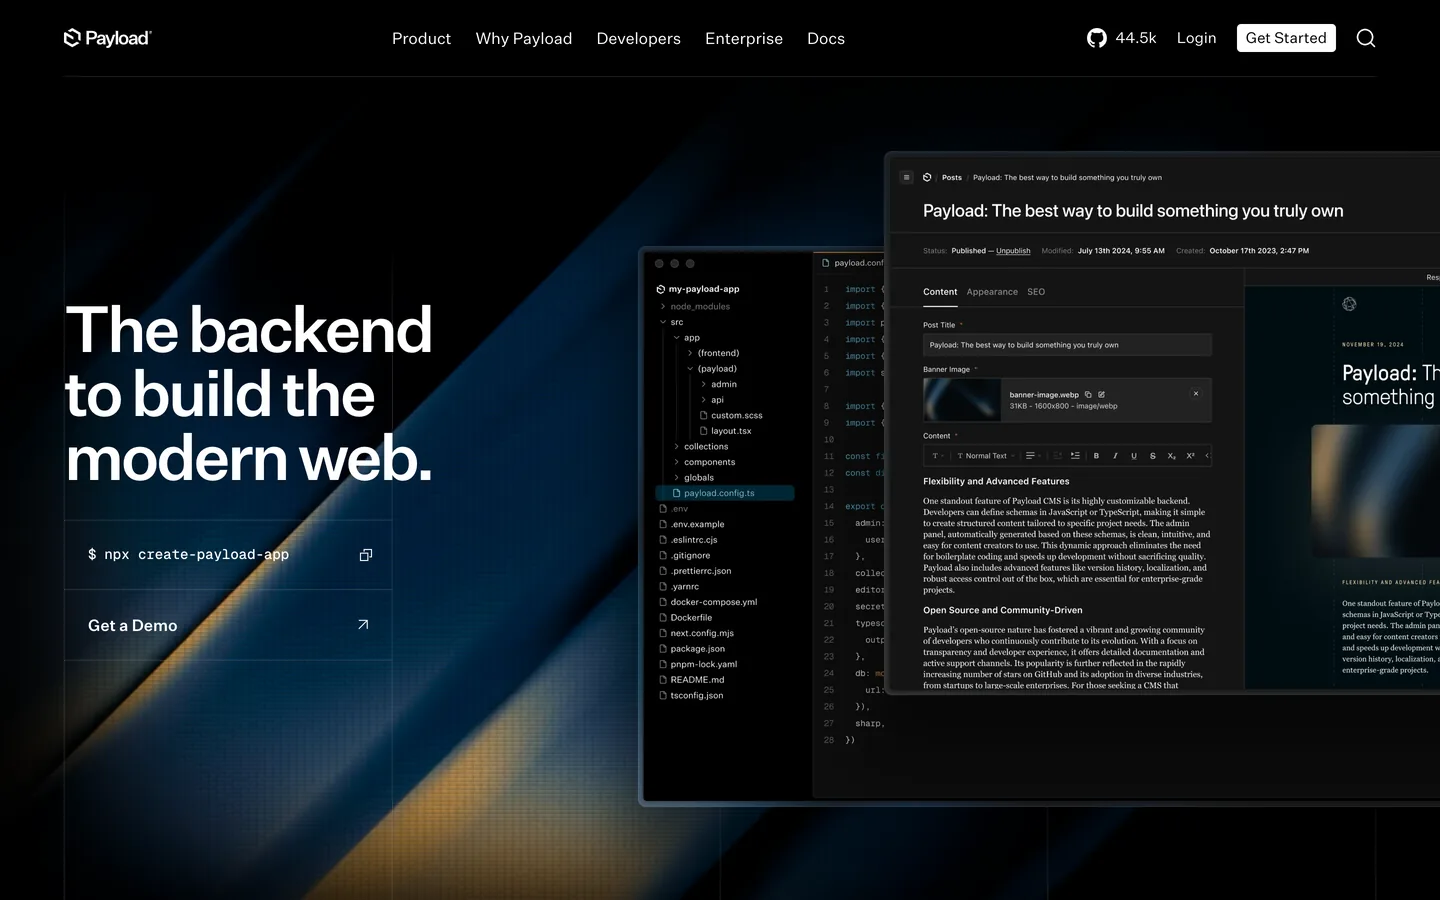
Хочете, щоб ваш сайт на Payload CMS з'являвся у відповідях ШІ, а не лише в класичних десяти синіх посиланнях? Payload CMS є headless CMS на TypeScript із підходом «спершу код», яку ви розміщуєте самі поруч зі своїм застосунком: редактори працюють із колекціями та глобальними об'єктами, описаними типізованими полями, а розробники читають і записують контент через REST, GraphQL і серверний Local API. Таке ядро, кероване схемою, робить її сильною основою для оптимізації під генеративні пошукові системи (GEO). Почніть із базового GEO та SEO аудиту і нехай кожен приріст накопичується в постійно оновлюваному дашборді GEO / SEO. У цьому посібнику показано, як змоделювати, відрендерити й розмітити Payload так, щоб Google та асистенти на кшталт ChatGPT, Perplexity, Claude і Gemini розуміли й цитували ваші сторінки.
Видимість тепер розділилася надвоє: це ранжовані посилання, за які ви вже боретеся, і короткий перелік джерел, що їх цитують ChatGPT, Perplexity, Claude і Gemini, відповідаючи на запитання. Generative Engine Optimization полягає в тому, щоб потрапити до цього переліку. Payload добре для цього підходить, бо контент визначається кодом: кожна колекція має типізовані поля, валідацію та зв'язки на основі MongoDB або Postgres, тож кожен документ поводиться як чіткий структурований запис, а не довільна сторінка. Оскільки Payload є headless, ви рендерите його через швидкий сучасний фронтенд і повністю контролюєте семантичний HTML, який моделі сприймають як окремі сутності.
Спершу виміряйте, потім будуйте. Поставте провідним асистентам реальні запитання вашої аудиторії, а тоді зафіксуйте, чи з'являються ваші сторінки і які URL вони цитують. Відстежуйте згадки бренду за допомогою відстеження згадок у ШІ, вивчайте джерела, які ви вже здобуваєте через зворотні посилання, що цитуються ШІ, і проведіть детальний GEO та SEO аудит, щоб скласти карту сутностей (бренд, люди, продукти), уже пов'язаних із вашим доменом. Цей орієнтир підкаже, які колекції та документи опрацювати насамперед.
У GEO намір приходить у вигляді повних промптів, а не уривчастих ключових слів. Зберіть точні формулювання, якими люди користуються в чаті та голосових запитах, і згрупуйте їх за завданнями: дізнатися, порівняти, вибрати, виправити. Розширте охоплення за допомогою інструмента розгалуження запитів у ШІ і розставте пріоритети тем за допомогою підбору ключових слів. Для кожного кластера визначте один канонічний документ Payload як сторінку, яку хочете бачити в цитатах, зробіть його стислим, придатним для цитування й підкріпленим явними доказами, щоб модель могла взяти уривок, не викрививши його сенсу.
Розглядайте свої колекції як хребет сутностей. Визначте колекції, як-от Posts, Categories, Products, Team, FAQs і Glossary, надайте кожній типізовані поля та з'єднайте їх полями зв'язків. Зіставте свої поля з властивостями schema.org, як-от name, description, image, datePublished, author, about і sameAs, і зберігайте SEO-метадані в окремій групі в кожній колекції. Оскільки схема є кодом, канонічні назви й факти лишаються одноманітними на всьому сайті, а офіційний SEO-плагін стандартизує поля заголовка й опису. Така повторювана глибина і є тематичною авторитетністю, яку відповідні системи цінують під час вибору джерела.
Payload є headless, тож поєднайте його зі швидким фронтендом на кшталт Next.js, Nuxt чи Astro й рендеріть сторінки на сервері. Payload тісно інтегрується з Next.js, тож ви отримуєте документи через Local API під час збирання або запиту й видаєте чистий семантичний HTML без клієнтської гідратації для контенту. Для статей використовуйте статичну генерацію або інкрементальну регенерацію, віддавайте ресурси через CDN і кешуйте агресивно. Швидкі сторінки з розміткою, доступною для сканування, збільшують охоплення скануванням і частоту цитування вас асистентами.
Формуйте метадані з полів колекцій: додайте офіційний SEO-плагін або власну SEO-групу, щоб кожен документ мав точний заголовок, мета-опис і значення Open Graph, що відповідають тексту. У фронтенді виводьте ці поля в head документа, будуйте чисті URL, багаті на сутності, зі slug і виводьте канонічні теги, щоб звести дублікати та посторінкові архіви до однієї адреси. Застосовуйте meta robots, щоб приховати від індексації малозмістовні списки тегів і відфільтровані перегляди, тож асистенти зчитують один цілісний сенс кожної сторінки.
У Payload JSON-LD живе у вашому фронтенд-фреймворку, а не в панелі адміністрування. У компоненті сторінки Next.js, Nuxt чи Astro виведіть блок script типу application/ld+json, заповнений з отриманого документа, щоб кожна сторінка видавала структуровані дані, побудовані на власних полях. Використовуйте Article разом із WebPage і BreadcrumbList для контенту, Product з offers для комерційних сторінок, HowTo для інструкцій і FAQPage для блоків запитань. Додайте загальносайтовий граф Organization з logo, contactPoint і посиланнями sameAs, щоб асистенти підтверджували факти й пов'язували ваші сторінки з визнаними сутностями.
Створюйте явні блоки запитань і відповідей, що повторюють реальні промпти, і додайте окрему групу полів FAQ або поле blocks, щоб редактори відтворювали цей шаблон у кожному відповідному документі. Тримайте кожну відповідь у межах від 50 до 120 слів, додавайте посилання на відповідну внутрішню сторінку й наводьте одне авторитетне зовнішнє джерело. Для процедур опишіть матеріали, впорядковані кроки й потрібний час у форматі HowTo. Такі компактні формати прибирають двозначності й спрощують асистентам цитування ваших сторінок Payload зі збереженням змісту.
Згенеруйте у фронтенді XML-карту сайту з переліком кожного опублікованого документа, а потім надішліть її в Google Search Console. У robots.txt дозвольте маршрути з контентом, придатним для цитування, і заборонте панель адміністрування та ендпоінти API. Опублікуйте файл llms.txt у корені домену з бажаними правилами сканування для ШІ-агентів, пріоритетними URL та умовами повторного використання. Цей файл дедалі частіше враховують, і він чітко вказує походження матеріалів моделям, які цитують джерела.
Будуйте тематичні хаби, що збирають споріднені документи та визначають ваші канонічні відповіді, а для чіткої ієрархії використовуйте глобальний об'єкт навігації та хлібні крихти. Додавайте контекстні вбудовані посилання з описовими анкорами та з'єднуйте кожен документ з його батьківським хабом і суміжними темами через поля зв'язків. Прискорте створення такої карти за допомогою генератора тематичних кластерів. Якщо частини вашого стеку працюють на інших платформах, застосуйте той самий підхід на Strapi, Directus, Webflow і Shopify.
GEO, як і раніше, тримається на авторитетності. Здобувайте цитування від поважних видань, первинних досліджень і спільнот TypeScript та розробників навколо проєктів на Payload. Публікуйте матеріали за підписом іменованих експертів, виводьте кваліфікацію рецензентів, ведіть докладні сторінки біографій і сторінку «Про нас», що посилюють E-E-A-T. Відстежуйте свою позицію в часі за допомогою трекера авторитетності домену і показуйте чітку дату останнього оновлення на стратегічних документах, щоб і Google, і асистенти сприймали ваш контент як актуальний та підтримуваний.
Payload CMS надає публічне API: кожна колекція автоматично отримує ендпоінти REST і GraphQL, що створюють документи, хоча окремого застосунку Make.com немає. Тому Sorank підключається через міст на вебхуках Make.com: кожну згенеровану статтю надсилають до сценарію Make.com, а Make публікує її в Payload через універсальний HTTP-модуль Make.com, який виконує POST до ендпоінта вашої колекції з ключем API. Нативного конектора Sorank поки немає, а цей маршрут автоматизує публікацію. Швидко готуйте оптимізовані чернетки за допомогою генератора статей для блогу, а потім публікуйте їх за розкладом. Спершу перевірте виклик створення контенту на вашому робочому екземплярі, а якщо ваша конфігурація його обмежує, скористайтеся власним блогом Sorank.
Відстежуйте, які промпти згадують ваш бренд, які документи цитують і де перемагають конкуренти. Порівнюйте себе за допомогою шпигуна за SEO-конкурентами, стежте за своєю позицією в рейтингу GEO та атрибутуйте візити від асистентів за допомогою позначених цільових сторінок і UTM-міток. Переглядайте дані після кожної нової розмітки, тематичного кластера та кампанії зі зворотних посилань і повторюйте цикл щомісяця, щоб GEO став вимірюваним двигуном зростання, який накопичує результат.
Payload CMS дає вам типізовану модель контенту з підходом «спершу код» і повний контроль над розміткою фронтенду, а GEO дає стратегію, яка виводить її перед відповідними системами. Коли ваші документи показують чіткі сутності, точні метадані та надійні докази, асистенти цитують вас упевнено. Налаштуйте структуровані колекції, швидкий фронтенд із серверним рендерингом, JSON-LD та відповіді, придатні для цитування, а тоді довірте Sorank аудити, контент і посилання, щоб ваш бренд став джерелом, яке моделі охоче цитують у 2026 році й надалі.

Payload CMS є чудовою основою для GEO, бо контент визначається кодом: кожна колекція має типізовані поля, валідацію та зв'язки на основі MongoDB або Postgres, тож ваші теми, люди й продукти сприймаються як чіткі сутності. Оскільки це headless-рішення, ви рендерите через швидкий фронтенд на кшталт Next.js із серверним рендерингом, що дає повний контроль над семантичним HTML. Додайте офіційний SEO-плагін для точних заголовків і значень Open Graph, виводьте JSON-LD зі свого фронтенду, формуйте чисті URL зі slug, згенеруйте XML-карту сайту й опублікуйте файл llms.txt. За такого налаштування ChatGPT, Perplexity, Claude і Gemini зможуть надійно знаходити, розбирати й цитувати ваш контент.
Пишіть сторінки за принципом «спершу відповідь», зіставлені з реальними промптами. Починайте кожну з підсумку з двох речень, далі давайте структурований план і тримайте абзаци коротшими за 120 слів. Дотримуйтеся суворої ієрархії заголовків (H2 над H3), додайте явні блоки FAQ із відповідями від 50 до 120 слів і підкріплюйте кожне твердження джерелом. Виводьте JSON-LD (Article, FAQPage, HowTo, Organization) зі свого фронтенд-фреймворку та зв'язуйте матеріали внутрішніми посиланнями, щоб хаби вели до споріднених документів через поля зв'язків. Окрема група полів FAQ або поле blocks дозволяє редакторам відтворювати цей шаблон у масштабі, сигналізуючи про тематичну глибину, яку відповідні системи розпізнають як авторитетну й безпечну для цитування.
Payload CMS надає публічне API: кожна колекція автоматично отримує ендпоінти REST і GraphQL, що створюють документи, а окремого застосунку Make.com немає, тож Sorank підключається через міст на вебхуках Make.com. Кожну статтю, яку генерує Sorank, вебхуком надсилають до сценарію Make.com, а Make публікує її в Payload через універсальний HTTP-модуль Make.com, який виконує POST до ендпоінта вашої колекції з ключем API. Окрім публікації, Sorank проводить GEO та SEO аудити, відстежує згадки в ШІ у ChatGPT, Perplexity і Gemini, стежить за конкурентами та пропонує оптимізацію контенту з однієї панелі. Спершу перевірте виклик створення контенту на вашому робочому екземплярі, а якщо ваша конфігурація його обмежує, скористайтеся власним блогом Sorank.
ВОНИ ПРОБУВАЛИ SORANK ДО ВАС
 “Я протестував Sorank на реальному сайті клієнта, і це неймовірно. Він робить усе, за що агенція виставила б вам рахунок на 1500 доларів на місяць. Тепер його запускають у роботу на цьому клієнті.”

 Guillaume Guersanguersanguillaume.com“Ми рекламна агенція і хотіли раз і назавжди повернути своє SEO в нормальне русло. Sorank дав нам чітке уявлення про наш сайт, допоміг розставити пріоритети оптимізацій і належним чином структурувати наш контент. Інструмент простий у використанні, добре продуманий для команди й дуже зручний для централізованого відстеження без жонглювання кількома платформами. Дуже міцна основа, щоб почати наше SEO з нуля.”
 Gaspard MadouiРекламна агенція
 “Я просто дозволив програмі Sorank повністю робити свою справу, і тепер мій показник DR дорівнює 25, а моя сторінка піднялася вище в пошуку.”
 Lucas Flandrefoundertrace.fr“Я спеціалізувалася на GEO завдяки Sorank. Рейтинг GEO дає змогу показувати клієнтам їхню позицію щодо конкурентів у ChatGPT. Це справжня комерційна перевага.”
 MélanieSEO-фрілансерка“Чудовий сервіс, добре працює для нашого сайту й допомагає зрозуміти, як його покращити, щоб вище ранжуватися в Google та поза ним. Вітаю, так тримати, рекомендую.”
 Hugo T.Власник інтернет-магазину



















