
Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Grafy znalostí ukládají entity a vztahy, aby AI mohla uvažovat o faktech a citovat je. Zjistěte, jak fungují, jak pohánějí GraphRAG a jak tvarují viditelnost v GEO.






Nástroje


Zakladatel Sorank, 7+ let zkušeností v SEO, nadšenec pro GEO.
Shrnutí
Grafy znalostí jsou síťové datové struktury, které ukládají entity jako uzly a vztahy mezi nimi jako hrany. Strojům dávají propojenou a prohledatelnou mapu faktů, nad kterou mohou uvažovat, místo hromady nesouvisejícího textu.
Chcete jít dál? Zeptejte se
Grafy znalostí jsou datový model se strukturou grafu, který zachycuje entity a vztahy mezi nimi. Místo ukládání údajů do řádků a sloupců nebo jako izolovaných dokumentů graf znalostí organizuje informace jako síť propojených uzlů a typovaných hran, které zachycují, jak spolu fakta souvisejí.
Právě tato propojená struktura je důvodem, proč se grafy znalostí stále častěji spojují s velkými jazykovými modely. Dávají systému AI síť příbuzných faktů, nad kterou může uvažovat, což zvyšuje přesnost a vysvětlitelnost. Porozumění jim objasňuje, jak moderní vyhledávače sestavují odpovědi podložené fakty a proč na viditelnosti záleží na strukturovaném obsahu čitelném pro stroje.
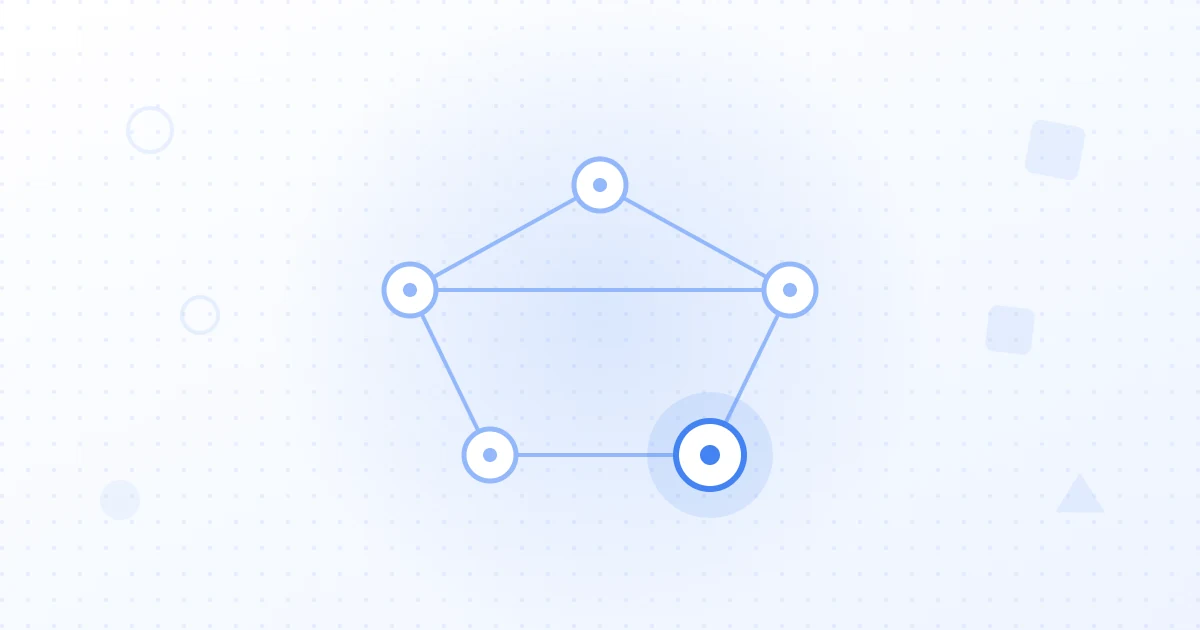
Graf znalostí je síťová reprezentace znalostí o reálném světě, kde každý uzel je entita a každá hrana je vztah mezi entitami. Entitami mohou být lidé, organizace, produkty nebo pojmy, a hrany popisují, jak spolu souvisejí, například založil, sídlí v nebo je součástí.
Liší se to od ploché databáze nebo složky dokumentů, protože vztahy jsou plnohodnotná data, nikoli něco, co musí čtenář odvozovat. Nejznámějším příkladem je vlastní Graf znalostí společnosti Google, ale koncept je obecný a podpírá širokou škálu systémů strojového učení a dat.
Základní jednotkou grafu znalostí je trojice: subjekt, vztah a objekt, například Firma X má generálního ředitele Y. Mnoho trojic navázaných za sebou tvoří graf. Uzly nesou entity, hrany nesou typované vztahy a vlastnosti přiřazují popisné atributy k oběma.
Ontologie funguje jako plán. Definuje, jaké typy entit existují, jaké vztahy jsou povolené a jaká logická omezení platí, například že každá objednávka musí obsahovat alespoň jeden produkt. Toto schéma udržuje graf konzistentní, a proto nad ním může software spolehlivě uvažovat, místo aby hádal.
Grafy znalostí obvykle žijí ve specializovaných grafových databázích nebo tripletových úložištích, jako jsou Neo4j, Amazon Neptune nebo RDF úložiště jako GraphDB a Stardog. Tyto systémy jsou optimalizované na procházení vztahů, hledání sousedů a spouštění grafových dotazů, které by byly v tradiční relační databázi pomalé.
Klíčovou výhodou je procházení přes více skoků. Databáze může přejít z uzlu k jeho sousedům, pak k sousedům sousedů a tak dál, a přirozeně tak odpovídá na otázky, které vyžadují spojení několika faktů. Schopnost sledovat řetězce vztahů dělá z grafů silný nástroj pro složité uvažování a přirozeně se hodí do hybridů s vektorovým vyhledáváním.
Běžné generování s vyhledáváním (retrieval augmented generation) bere nalezené dokumenty jako oddělené, nestrukturované celky. Pomocí sémantické podobnosti najde relevantní úryvky a model je musí sám poskládat dohromady. To funguje u jednoduchých otázek, ale selhává, když odpověď vyžaduje spojení faktů rozložených mezi mnoho zdrojů.
Grafy znalostí doplňují chybějící strukturu. Zatímco obyčejné vyhledávání najde text, který vypadá podobně, graf kóduje, jak spolu fakta skutečně souvisejí, takže systém může načíst propojenou síť informací místo izolovaných útržků. Oba přístupy se doplňují a mnoho moderních postupů je kombinuje.
GraphRAG integruje vyhledávání nad grafem vedle vyhledávání textu. Při zodpovídání otázky systém dotáže graf znalostí na související entity a jejich vazby a tento strukturovaný kontext předá modelu. Výsledkem je, že odpovědi stojí na explicitních faktech a model zvládá uvažování přes více skoků v grafu.
Přináší to několik výhod. Zlepšuje se konzistence, protože graf, který ví, že produkt má díl A a díl B, může uvést přesně tyto díly, místo aby je halucinoval. Zlepšuje se i vysvětlitelnost, protože systém dokáže vystopovat uzly a hrany, ze kterých odpověď vznikla. Grafy znalostí také rozlišují významy výrazů: prostřednictvím vztahů odliší Jaguar jako výrobce automobilů od jaguára jako zvířete.
Jednou z největších předností je méně nepravdivých odpovědí. Tím, že ukotví generování do strukturovaných a ověřených vztahů, graf omezuje, co může model tvrdit, a přímo tak snižuje halucinace AI. Model už nehádá, jak spolu roztroušené pasáže souvisejí, protože graf už spojení kóduje.
Stejná struktura přidává i jasný řetězec uvažování. Protože lze každou odpověď vystopovat k určitým uzlům a hranám, mohou týmy zkontrolovat, proč systém řekl to, co řekl, a to buduje důvěru. Tuto vysvětlitelnost je těžké dosáhnout u vyhledávání pouze nad textem, kde je cesta od zdrojů k odpovědi nepřehledná a obtížně ověřitelná.
Grafy znalostí odměňují obsah, který stroje dokážou rozložit na entity a vztahy. Když vaše stránky používají strukturovaná data a konzistentní fakta, lze je snáz zařadit do grafů, na nichž se vyhledávače a systémy AI spoléhají, což zvyšuje šanci, že budete zobrazeni a citováni. Toto je základní myšlenka SEO založeného na entitách.
V praxi to znamená označovat entity, udržovat fakta konzistentní napříč stránkami a budovat skutečnou tematickou hloubku, aby se váš obsah do grafu čistě vkládal. Spojení se silným strukturovaným obsahem a soustředěným výzkumem klíčových slov a plánováním obsahu pomáhá klasickým vyhledávačům i AI váš obsah pochopit a důvěřovat mu.
Kromě vyhledávání pohánějí grafy znalostí agentní asistenty AI, odhalování podvodů, bezpečnostní grafy, mapování finanční compliance a doporučovací systémy. Ve všech případech spočívá přínos v propojení dat, která by jinak zůstala izolovaná, a v dotazování těchto spojení, aby se objevil přehled.
U aplikací jazykových modelů se grafy osvědčují zejména u úloh, kde je přesnost klíčová a chybné spojení stojí hodně. Odpovídání na otázky ve složitých oborech, podnikové vyhledávání napříč mnoha systémy a chatboti, kteří musí dávat konzistentní a kontrolovatelné odpovědi, všechny těží z grafové vrstvy za modelem.
Grafy znalostí mění roztroušená fakta v propojenou a prohledatelnou strukturu, nad kterou mohou stroje uvažovat, a proto stojí stále častěji za spolehlivými odpověďmi AI. Tím, že entity a vztahy kódují explicitně, snižují halucinace, podporují uvažování přes více skoků a činí výsledky vysvětlitelnými.
Chcete-li jít dál, propojte to s generováním s vyhledáváním a SEO založeným na entitách a pochopte, jak strukturovaná fakta pohánějí jak AI podloženou odpověď, tak viditelnost ve vyhledávání. Zdroje: IBM a GoodData.
Zdroje

Běžná databáze ukládá data do řádků a sloupců a se vztahy zachází jako s něčím, co se spojuje až v čase dotazu. Graf znalostí ukládá vztahy jako plnohodnotná data, jako popsané hrany mezi uzly entit. To výrazně usnadňuje procházení souvislostí, zodpovídání otázek přes více skoků a uvažování o tom, jak fakta v oboru souvisejí.
Běžné generování s vyhledáváním nachází textové úryvky podle sémantické podobnosti a nechává model, aby je sestavil. GraphRAG přidává graf znalostí, takže systém načte propojenou síť příbuzných entit a vztahů místo izolovaných útržků. Odpovědi tak stojí na strukturovaných faktech, podporují uvažování přes více skoků a snižují halucinace u složitých otázek.
Nepřímo ano. Obsah s jasnými entitami, strukturovanými daty a konzistentními fakty se vyhledávačům a systémům AI snáze mapuje na grafy, na nichž stavějí své odpovědi. Když jsou vaše informace čitelné pro stroje a spolehlivé, je pravděpodobnější, že budou zobrazeny a citovány, což je ústřední cíl optimalizace založené na entitách a generativní optimalizace.
VYZKOUŠELI SORANK PŘED VÁMI
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu


















