React SEO 指南:为什么客户端渲染会拖慢索引,何时选择 SSR 或预渲染,如何在 React 19 中设置元标签,并让 AI 读懂你的页面。
工具

简而言之
React 可以在 Google 上获得排名,但默认的单页应用发送的 HTML 几乎为空,需要依赖 JavaScript 才能显示内容,这会延迟索引,并让大多数 AI 爬虫看不到页面。可靠的解决办法是由服务器输出 HTML:在构建时预渲染静态页面,或使用支持服务器渲染的框架(Next.js、React Router)。然后为每个网址设置唯一的标题、描述和规范链接,使用真正的链接和正确的状态码,并检查机器人实际收到的内容。
想深入了解?请询问
快速测验
SEO 适合您吗?该如何开始?
React SEO 的目标是让 React 应用能够被搜索引擎和 AI 助手抓取、索引和理解。React 本身是中立的:问题出在把一切都放到浏览器中渲染。Google 在 JavaScript SEO 基础知识中确认,它分三个阶段处理 JavaScript 应用(抓取、渲染、编入索引),并指出服务器端渲染或预渲染"仍然是个好主意,因为它能让网站对用户和爬虫都更快,而且并非所有机器人都能运行 JavaScript"。
以单页应用方式创建的 React 应用,交付的 HTML 文件里几乎只有一个空的根 div 和一个 script 标签。浏览器下载 JavaScript、执行它,然后构建页面。只读取 HTML 的爬虫看不到任何可索引的内容:没有标题,没有正文,也没有链接。
Googlebot 确实会执行 JavaScript,但这是一个单独的步骤:页面先被抓取,进入渲染队列,在无界面 Chromium 中渲染,之后才会使用渲染出的链接和内容。每多一个步骤,就多一次失败的可能(脚本错误、API 被屏蔽、超时),新页面出现在搜索结果中的时间也会推迟。我们的 JavaScript SEO 指南详细介绍了这一流程,关于 Google 索引的文章则说明了如何加快页面收录。
其他机器人没那么有耐心。Vercel 于 2024 年 12 月发布的分析 The rise of the AI crawler 发现,"目前没有任何主要 AI 爬虫会渲染 JavaScript",点名了 GPTBot、ChatGPT-User、OAI-SearchBot、ClaudeBot 和 PerplexityBot。客户端渲染的 React 页面对 ChatGPT、Claude 和 Perplexity 不可见,即使 Google 已经将其编入索引。
React 团队现在建议用框架来创建新应用。在 2025 年 2 月 14 日停用 Create React App 时,团队在公告中写道,"服务器渲染可以改善 SEO",同时还能减少用户在看到内容前需要下载的 JavaScript,从而提升性能。以下选项按对搜索的友好程度从弱到强排列:
| 方式 | 机器人收到的内容 | SEO 评价 | 常用工具 |
|---|---|---|---|
| 客户端渲染(SPA) | 空 HTML,内容需等 JavaScript 执行后出现 | 较弱:索引延迟,AI 爬虫不可见 | Vite + React、旧的 Create React App 项目 |
| 动态渲染 | 只向机器人提供预渲染 HTML | 权宜之计,Google 不推荐 | 预渲染服务、无界面浏览器代理 |
| 构建时静态预渲染 | 每个已知网址都有完整 HTML | 非常适合很少变化的内容 | React Router 预渲染、静态网站生成器、Next.js 静态导出 |
| 服务器端渲染 | 每次请求都返回完整 HTML,随后水合 | 最适合大型或频繁更新的网站 | Next.js、React Router(框架模式,前身为 Remix) |
关于动态渲染,Google 文档说得很明确:它"只是一种权宜之计,并非长期解决方案",Google 推荐改用服务器端渲染、静态渲染或水合。如果你正在选择框架,我们的 Next.js SEO 指南详细介绍了渲染模式、Metadata API 和站点地图。
如果无法迁移,只要稍加注意,单页应用仍然可以被 Google 索引。我们的单页应用 SEO 指南列出了相关条件;本文其余内容对两种情况都适用。
自 React 19(2024 年 12 月 5 日发布稳定版)起,组件可以直接渲染 title、meta 和 link 标签,React 会把它们提升到文档的 head 中。React 19 发布说明指出,这种原生支持适用于"纯客户端应用、流式 SSR 和 Server Components"。在 React 19 之前,这项工作由 react-helmet 或 react-helmet-async 等库完成,它们在需要按路由覆盖默认值时仍然有用。
function ProductPage({ product }) {
  return (
    <>
      <title>{`${product.name} | Shop`}</title>
      <meta name="description" content={product.summary} />
      <link rel="canonical" href={`https://example.com/p/${product.slug}`} />
      <h1>{product.name}</h1>
    </>
  )
}
无论使用哪种方法,都要遵守三条规则:
注意
在纯客户端应用中,React 渲染的标签只有在 JavaScript 执行后才存在。Google 可以在渲染后读取它们,而 AI 爬虫和大多数社交网络预览机器人则不能。服务器渲染或预渲染会把这些标签放进 HTML 响应,让所有机器人都能看到。
Google 表示,它"只有在链接是带有 href 属性的 a 元素时才能发现链接",并建议不要使用网址片段来加载不同内容。大多数 React SEO 问题都源于路由细节:
| 错误 | 后果 | 解决方法 |
|---|---|---|
| 在 div 或按钮上用 onClick 导航 | Google 找不到可跟踪的链接 | 使用路由器的 Link 组件,它会渲染带 href 的 a |
| 哈希路由(/#/products) | 在 Google 看来所有页面共用一个网址 | 使用基于历史记录的路由(/products),配合 BrowserRouter 或框架 |
| "未找到"页面返回 200 状态码 | Search Console 中出现"软 404" | 由服务器返回真正的 404,或在纯 SPA 中用 JavaScript 添加 noindex |
| 仅在客户端重定向 | 重定向缓慢或被忽略 | 对已迁移页面使用服务器端 301 或 308 重定向 |
| 内容在点击或滚动后才加载 | 爬虫永远看不到这些文字 | 在页面加载时渲染主要内容;用真实网址为列表分页 |
| robots.txt 屏蔽了 JavaScript 或 API | Google 渲染出空白页面 | 放行页面所需的脚本和 API 接口 |
要查看 Google 渲染出的内容,请使用 Search Console 的网址检查工具查看测试页面的 HTML,或用可索引性检查工具检测关键页面模板。
React 没有内置站点地图。请在构建时根据路由和数据生成 sitemap.xml(或使用框架自带的站点地图功能),只列出返回 200 的规范网址,并在 robots.txt 中引用它。小型静态网站使用 XML 站点地图生成器即可。
结构化数据与元数据遵循同样的规则:用与页面相同的数据,把 JSON-LD 脚本与页面一起渲染,最好在服务器端完成。Google 可以在渲染后读取由 JavaScript 注入的 JSON-LD,但初始 HTML 中缺少的标记,对不渲染的爬虫来说同样不存在。文章使用 Article,电商使用 Product,全站使用 Organization,深层页面使用 BreadcrumbList。
提示
对页面网址运行 curl,在输出中搜索它的 H1 和正文中的一句话。如果找不到,Google 也许会在渲染后编入索引,但 AI 爬虫什么也看不到。
庞大的 JavaScript 包会损害 Core Web Vitals:浏览器必须先下载、解析并水合代码,页面才能响应,这会拖累 Largest Contentful Paint 和 Interaction to Next Paint,移动端尤为明显。React 团队关于 Create React App 的公告指出,服务器渲染发送的 JavaScript 更少,并提供完整的 HTML 文档,从而加快 First Contentful Paint,还可能降低 INP。实用做法:用 React.lazy 按路由拆分代码,为图片指定明确尺寸,延迟加载首屏以下的组件,并审查第三方脚本。
GEO(生成式引擎优化)从可访问性开始。由于 AI 爬虫获取的是原始 HTML,React 页面必须在不依赖 JavaScript 的情况下提供正文、标题和 JSON-LD,才能被读取、总结和引用。网站 AI 可抓取性审核可以展示这些机器人从你的页面收到了什么。第二个前提是值得引用的内容:每个章节回答一个问题,附带来源、数据和清晰定义。
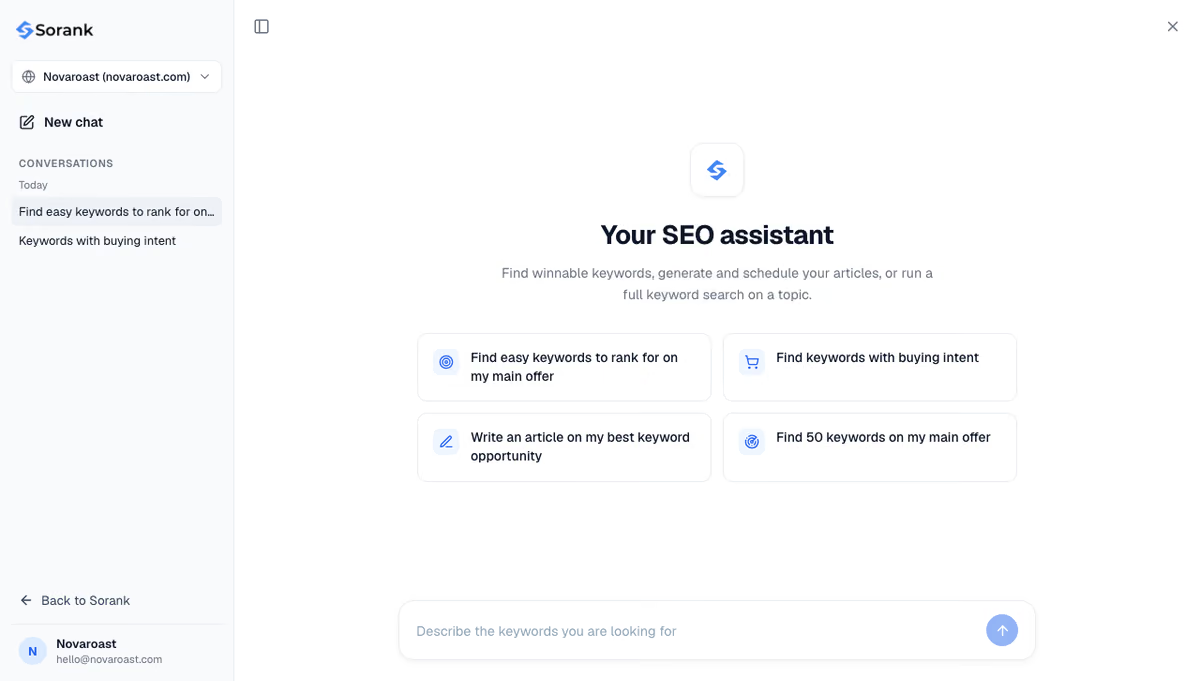
这部分内容工作正是我们的产品 Sorank 自动完成的。Sorank 是一款 autopilot 模式的 SEO 与 GEO 软件:其博客文章生成器每月撰写并发布 20、60 或 120 篇文章,附带来源、内部链接和图片,并可通过 webhook 接入 React 或 Next.js 等自定义技术栈。其 SEO Chat 以对话方式回答有关你网站搜索表现的问题。
一句话总结:由服务器输出 HTML,为每个网址设置独立的标题、描述和规范链接,并使用真正的链接。这样,React 网站就能像其他网站一样获得排名,AI 助手也能读取它。如需持续为网站提供面向 Google 和 AI 的文章,请查看 Sorank 的方案,每月 49 美元起,可免费试用 3 天。

不是。React 是一个用户界面库,其 SEO 表现取决于页面的渲染方式。客户端渲染的单页应用发送空 HTML,依赖 Google 的渲染步骤,这会延迟索引,并让 AI 爬虫看不到内容。同样的 React 代码如果采用服务器渲染或静态预渲染,就能像传统网站一样获得排名。
会。Googlebot 使用较新版本的 Chromium 执行 JavaScript,因此能够索引 React 应用在浏览器中构建的内容。渲染发生在抓取之后,如果脚本出错或 API 被屏蔽,渲染可能会延迟或失败。Search Console 的网址检查工具可以显示 Google 看到的渲染后 HTML。
简单场景下不需要。React 19 可以在任意组件中渲染 title、meta 和 link 标签,并将其提升到文档的 head 中。当你需要按路由覆盖全站默认值,或需要支持旧版 React 时,react-helmet-async 等库仍然有用。
我们免费分析您的竞争对手、网站和 AI 可见度,为您制定专属内容计划。
 AI 内容简报生成器
 FAQ 结构化数据生成器
 AI 文章选题生成器
 结构化数据验证工具(Schema 验证器)
 图片替代文本检查工具
 内部链接分析工具
 外链挑战
 AI meta 描述生成器
 AI 博客标题生成器
 Google 可收录性检查工具
 AI 文章大纲生成器
 UTM 链接生成器
 关键词聚类工具
 规范标签检查工具
 XML 站点地图生成器
 死链检查工具
 AI SEO 标题生成器
 标题评分工具
 搜索结果预览工具
 重定向检查工具
 hreflang 标签生成器
 标题结构分析工具
 HTTP 响应头检测工具
 Favicon 提取工具
 SEO 流量与收入预测计算器
 SEO 预算计算器
 排名提升模拟器
 关键词机会得分计算器
 GEO 内容投入计算器
 客户终身价值计算器
 点击率计算器
 AI 流量价值计算器
 AI 声量份额计算器
 Gemini 排名查询工具
 ROAS 计算器
 自然流量价值计算器
 本地 SEO 投资回报计算器
 外链建设成本计算器
 关键词密度计算器
 客户获取成本计算器
 单篇文章成本计算器
 跳出率计算器
 AI 引用率计算器
 结构化数据大语言模型审计
 llms.txt 生成器
 站点地图检查工具
 SERP 波动监测器
 字数统计工具
 结构化数据生成器
 关键词研究工具
 SEO 盈亏平衡计算器
 阅读时长计算器
 自然流量预估工具与网站流量查询
 ChatGPT 引荐流量估算器
 AI 曝光度得分计算器
 LLM 可读性检查器
 SearchGPT 就绪度检测工具
 ChatGPT 为什么不推荐我的网站
 URL 提取工具
 网页转 Markdown
 Robots 生成器
 OG 预览
 页面 SEO 审核:SEO 检查与 SEO 分析工具
 LTV 与 CAC 比率计算器
 GEO 回报率计算器
 转化率计算器
 网站可抓取性 AI 审计
 AI 搜索曝光度测试
 页面体积检测工具
 URL Slug 生成器
 Meta 标签生成器
 图片压缩工具
 网站图标生成器
 域名权重查询工具
 SERP 点击率计算器
 电商 SEO 投资回报率计算器
 内容营销投资回报率计算器
 AI 隐形成本计算器
 AI Overview 检查工具与 AI Overviews 排名检查
 Robots.txt 检查工具
 AI SEO 审核
 Perplexity 引用检测工具
 回答引擎优化审核
 ChatGPT 可见度检测工具
 外链分析工具
 SEO 与付费搜索省钱计算器
 SEO 声量占比计算器
 SaaS SEO ROI 计算器
 反向链接投资回报率计算器
 llms.txt 验证器
 LLM 引用检查器
 GEO 审核
 SEO ROI 计算器
 关键词价值计算器
他们已先于您体验了 SORANK
 “两年来,我 100% 的客户都来自 LinkedIn。每天发帖、评论、私信跟进……完全依赖算法。我知道自己需要做 SEO,但总是往后拖:太花时间、太技术、不是我的本行。有了 Sorank,我终于迈出了这一步。4 个月里,我在什么都不发的情况下每月获得 15 个自然线索。目前还没有做到和 LinkedIn 各占一半,但知道自己现在有了第二个能自动增长的线索来源,我睡得更踏实了。”
 Valentin Thomy冷邮件营销机构
 “我是开发者,不是做市场的。我的 Shopify 主题此前只靠口碑和广告在卖。有了 Sorank,我终于明白该如何搭建自己的 SEO,以及怎样写出能获得排名的文章。审计发现我的产品页面太慢了。两个月内,我的自然流量翻了一倍,当人们搜索 Shopify 主题时,我也开始出现在 ChatGPT 的回答里。而这一切每周只花大约 2 小时。”
 Thème FullStackgo.themefullstack.com
 “对市场营销机构来说是个很棒的工具!用它来审计网站、找出加载慢的页面、确定需要补充哪些内容以及补在哪里,都非常快。”
 Thomas Giraudthe-deployer.fr“我们是一家广告代理商,想要一劳永逸地把 SEO 重新做起来。Sorank 让我们清楚地看到自己网站的情况,帮助我们排定优化的优先级,并把内容结构梳理好。这个工具易于使用,很适合团队,而且非常实用,可以集中跟踪,不用在多个平台之间来回切换。这是我们重新开始做 SEO 的一个非常扎实的基础。”
 Gaspard Madoui广告代理商