
Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Agregace zdrojů je způsob, jakým AI vyhledávání stahuje a slučuje pasáže z mnoha zdrojů do jedné odpovědi. Zjistěte, jak funguje a jak se dostat do citací.






Nástroje


Zakladatel Sorank, 7+ let zkušeností v SEO, nadšenec pro GEO.
Shrnutí
Agregace zdrojů je fáze AI vyhledávání, ve které systém shromáždí pasáže z mnoha různých zdrojů, odstraní duplicity a výsledky vyfiltruje, a nejlepší z nich pak sloučí do jediné sady podkladů, z níž model vytvoří jednu odpověď s citacemi.
Chcete jít dál? Zeptejte se
Agregace zdrojů je proces, při kterém systém AI vyhledávání sbírá obsah z mnoha míst, z webového indexu, fór, recenzí, přepisů videí i znalostních bází, a skládá jej do jedné souvislé odpovědi. Místo seznamu odkazů systém vytáhne relevantní pasáže z desítek dokumentů a sloučí je do kontextu, nad kterým uvažuje.
Tento krok je jádrem toho, jak AI asistenti odpovídají. Poté, co dotaz rozvětví do mnoha dílčích dotazů a pro každý získá výsledky, musí systém sladit překrývající se a místy si protiřečící informace do jediné odpovědi. Pochopení agregace vysvětluje, proč se některé značky citují znovu a znovu, zatímco jiné, i když se umisťují dobře, se v odpovědi nikdy neobjeví.
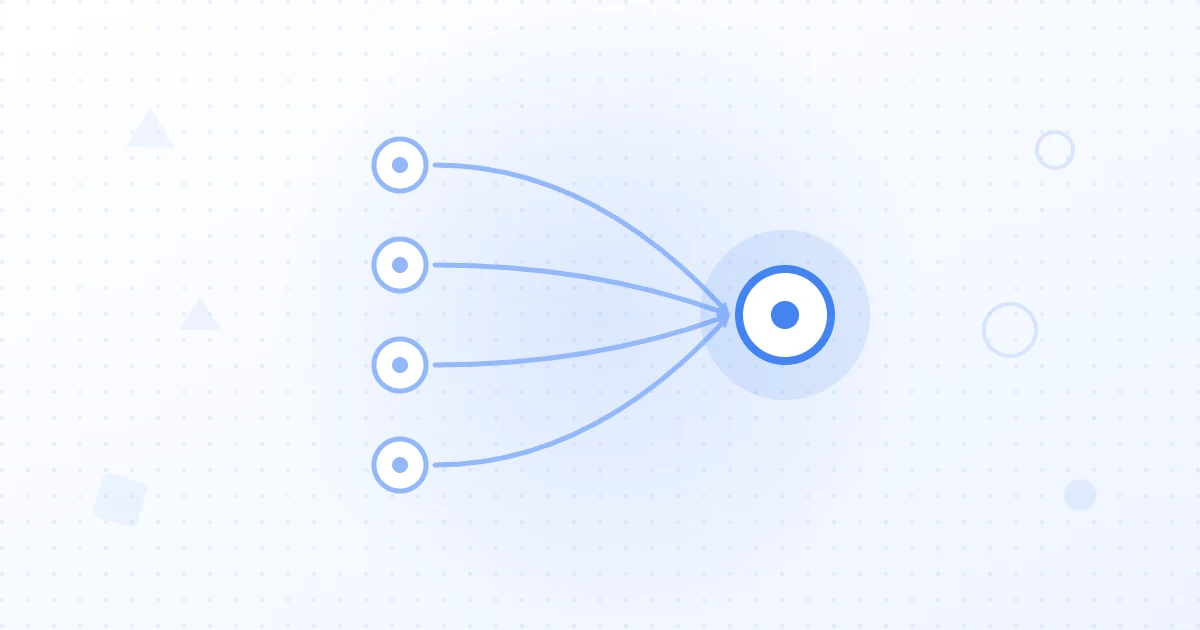
Agregace zdrojů je prostřední fáze pipeline AI vyhledávání, která leží mezi načítáním a syntézou. Jakmile systém shromáždí kandidátní pasáže z více vyhledávacích zdrojů, agregace je sloučí do jediného souboru, odstraní duplicity, vyfiltruje podle kvality a seřadí to, co zbylo. Výstupem je vybraná sada pasáží, kterou model skutečně přečte.
Nejlépe se chápe v širším toku: porozumění dotazu, rozvětvení dotazu, načítání z mnoha zdrojů, agregace a filtrace, pak syntéza jazykovým modelem. Agregace je okamžik, kdy systém rozhodne, které z mnoha nalezených věcí stojí za to, aby na nich odpověď stála. Přímo se napojuje na syntézu z více zdrojů, kde se sloučené pasáže mění v jednu odpověď.
Proces začíná šíří. Rozvětvení dotazu (query fanout) rozšíří jednu otázku do několika dílčích dotazů, z nichž každý cílí na jiný úhel, a spustí je souběžně napříč webovým indexem, znalostním grafem, přepisy videí a dalšími indexy. Dotaz na plán půlmaratonu se tak může rozvětvit na tréninkové plány, výživu a prevenci zranění najednou.
Každý dílčí dotaz vrací vlastní seřazené výsledky, takže systém musí spojit mnoho seřazených seznamů do jednoho. Běžnou metodou je vzájemná fúze pořadí (reciprocal rank fusion), která hodnotí každý dokument podle toho, jak dobře se umisťuje napříč více variantami dotazu, a upřednostňuje zdroje, které se soustavně objevují blízko vrcholu. Odměňuje to obsah, který odpovídá na celý shluk souvisejících otázek, a ne jen na jednu.
Po sloučení se množina kandidátů vyčistí. Odstranění duplicit vyřadí téměř shodné pasáže, aby stejný názor nevytlačil ostatní zdroje. Pak se uplatní filtry kvality, včetně hodnocení reputace podle principů zkušenosti, odbornosti, autority a důvěry (E-E-A-T), omezení bezpečnosti obsahu a váhy aktuálnosti, která upřednostňuje současné informace.
Nenápadným, ale rozhodujícím filtrem je vytěžitelnost úryvků: systémy dávají přednost pasážím, které lze čistě vložit do syntetizované odpovědi. Obsah zahrabaný v husté a nestrukturované próze se hůř vytěžuje než jasné a samostatně srozumitelné tvrzení. Právě v této fázi filtrace mnoho jinak relevantních stránek vypadne a do podkladové sady se nedostane.
Přeživší nejlepší pasáže se stanou kontextem ukotvení, tedy důkazy, které model dostane k sestavení odpovědi. Model přečte tuto vybranou sadu, syntetizuje souvislou odpověď a rozhodne, kam citace umístí, zda přímo v textu, v postranním panelu, nebo v seznamu zdrojů. Platformy se liší: Perplexity citace zdůrazňuje, zatímco přehledy Google AI Overviews zobrazují odkazy v textu vedle syntézy.
Toto je mechanismus stojící za ukotvením AI, tedy navázáním vygenerovaného textu na načtené zdroje. Celý tok, tedy načtení, agregace, ukotvení a generování, je jádrem generování rozšířeného o vyhledávání a agregace je brána, která rozhoduje, které zdroje si citaci zaslouží.
Agregace mění pohled na viditelnost. Protože systém čerpá z mnoha zdrojů a odměňuje ty, které se objevují napříč více dílčími dotazy, záleží víc na šíři a konzistenci než na jediném umístění. Stránka, která jednu otázku odpoví dokonale, může prohrát se značkou, o které se soustavně mluví napříč mnoha souvisejícími otázkami a platformami.
Konzistence napříč zdroji je obzvlášť silná. Když model vidí, že značka je popisována stejným způsobem u externích vydavatelů, v přepisech videí, recenzích i v komunitních diskusích, syntetizuje tento vzorec do své odpovědi. Proto získání citací LLM závisí na soudržné přítomnosti na webu, a ne jen na vlastním webu.
Udělejte svůj obsah snadno dohledatelný, vytěžitelný a důvěryhodný. Jasně uveďte, čím jste, v jednoduchých větách ve tvaru podmět, přísudek, předmět, například hned v úvodu pojmenujte kategorii a cílové publikum, aby systém pasáž zařadil a mohl ji vytáhnout. Stránky strukturujte tak, aby jednotlivé sekce odpovídaly na konkrétní otázky, protože agregace pracuje na úrovni pasáží, a ne celé stránky.
Budujte na shlucích, ne na jednotlivých klíčových slovech. Odpovídejte na sousední a implicitní otázky kolem tématu, aby se váš obsah objevil napříč mnoha dílčími dotazy a dobře obstál při vzájemné fúzi pořadí. Spojením s důsledným výzkumem klíčových slov a plánováním obsahu pokryjete celý shluk otázek, který rozvětvení vygeneruje.
Systémy AI si fakta ověřují napříč platformami, takže samotný vlastní web nestačí. Zmínky na recenzních serverech, v oborových médiích a na komunitních fórech fungují jako potvrzení, které zvyšuje pravděpodobnost citace. Analýzy citací v B2B ukázaly, že převažují komunitní a recenzní platformy, přičemž mezi nejčastěji citované zdroje patří Reddit a G2.
Praktickým důsledkem je usilovat o konzistentní vymezení všude, kde se o vaší značce mluví. Když se váš popis, tvrzení a kategorie shodují na vašem webu i u externích zdrojů, agregace tuto shodu bere jako silný signál důvěry. Protichůdné informace napříč zdroji naopak oslabují vzorec, který může model s jistotou syntetizovat.
Agregace může selhat. Když si zdroje odporují, model může protichůdná tvrzení sloučit do sebejisté, ale nepřesné odpovědi, a vy nemůžete ovlivnit, které pasáže systém vybere nebo jak je zváží. Filtry aktuálnosti mohou také pohřbít dobrý nadčasový obsah, pokud se do sady nahrnou novější a slabší stránky.
Pro marketéry tato omezení znamenají vliv, ne kontrolu. Obsah můžete učinit lépe dohledatelným, vytěžitelným a konzistentním, ale zaručit zařazení do jediné odpovědi nelze, zvlášť vzhledem k pravděpodobnostní povaze těchto systémů. Agregaci berte jako proces, který optimalizujete v čase napříč mnoha dotazy, a ne jako vypínač, který stačí přepnout.
Agregace zdrojů je fáze, ve které AI vyhledávání slučuje pasáže z mnoha zdrojů, odstraňuje duplicity a filtruje je a sestavuje podkladovou sadu za syntetizovanou odpovědí. Odměňuje šíři, vytěžitelnost a konzistenci napříč zdroji mnohem víc než jediné přední umístění. Pro značky znamená být citován spolehlivou přítomnost napříč shluky otázek a platformami, které model živí.
Propojte to se syntézou z více zdrojů a mechanikou rozvětvení dotazu a k pokrytí celého shluku otázek, který AI bude agregovat, použijte výzkumné a plánovací nástroje Sorank. Zdroje: iPullRank a Discovered Labs.
Zdroje

Agregace zdrojů je fáze, ve které systém AI spojí pasáže načtené z mnoha různých zdrojů do jediného souboru, odstraní duplicity, vyfiltruje podle kvality a aktuálnosti a seřadí to, co zbylo. Přeživší pasáže se stanou kontextem ukotvení, nad nímž model čte a syntetizuje jednu odpověď. V pipeline AI vyhledávání leží mezi načítáním a syntézou.
Poté, co se dotaz rozvětví do více dílčích dotazů, systém pro každý z nich načte seřazené výsledky a pak je sloučí metodami jako vzájemná fúze pořadí, která upřednostňuje zdroje s vysokým umístěním napříč mnoha variantami dotazu. Odstraní duplicity, použije filtry kvality a reputace a dává přednost pasážím, které se čistě vytěžují. Obsah, který se soustavně objevuje napříč shlukem i platformami, má větší šanci na citaci.
Pište jasné, samostatně srozumitelné pasáže, z nichž každá odpovídá na konkrétní otázku, protože agregace pracuje na úrovni pasáží. Výslovně uveďte, čím jste a koho obsluhujete, aby vás systém mohl zařadit. Pokrývejte celý shluk souvisejících otázek, a ne jednu stránku, a budujte konzistentní zmínky na recenzních serverech, fórech a v médiích, protože systémy AI si fakta ověřují napříč více zdroji.
VYZKOUŠELI SORANK PŘED VÁMI
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu


















