
Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Vektorsøgning finder resultater ud fra betydning, ikke søgeord, ved hjælp af embeddings og lighed. Lær, hvordan den virker, og hvorfor den betyder noget for SEO og GEO.






Værktøjer


Grundlægger af Sorank, 7+ års erfaring inden for SEO, GEO-entusiast.
Resumé
Vektorsøgning finder og henter elementer ud fra betydning frem for præcise ord. Den omdanner data til numeriske embeddings og rangerer resultaterne efter, hvor tæt embeddingerne ligger i et rum med mange dimensioner.
Vil du vide mere? Spørg
Vektorsøgning er en teknik til at finde lignende elementer i store datasæt ved at sammenligne numeriske repræsentationer af deres betydning frem for at matche søgeord. Hvert indholdsstykke, en sætning, et dokument eller et billede, omdannes til en vektor: en række tal, der fanger dets semantiske indhold. Systemet henter derefter de elementer, hvis vektorer ligger tættest på forespørgslens vektor. Det betyder, at det kan finde det rigtige svar, selv når ingen af de præcise ord stemmer overens.
Det betyder noget, fordi de søgemaskiner, folk nu bruger, fra Googles AI-funktioner til ChatGPT og Perplexity, støtter sig til vektorsøgning for at hente relevante afsnit, før de formulerer et svar. At forstå, hvordan den rangerer indhold efter betydning, er første skridt til at gøre dine sider hentbare for de systemer, der i stigende grad afgør, hvad der bliver citeret.
Vektorsøgning bruger maskinlæring til at fange betydningen og konteksten i ustruktureret data, herunder tekst, billeder og lyd, og omdanne det til en numerisk repræsentation. I modsætning til traditionel søgning, der bygger på præcise match, leder den efter lighed baseret på betydning. En opskrift med titlen næringsrig madpakke til travle aftener kan matche forespørgslen sunde aftensmadsidéer, fordi deres vektorer deler semantiske træk, selvom ordene er forskellige.
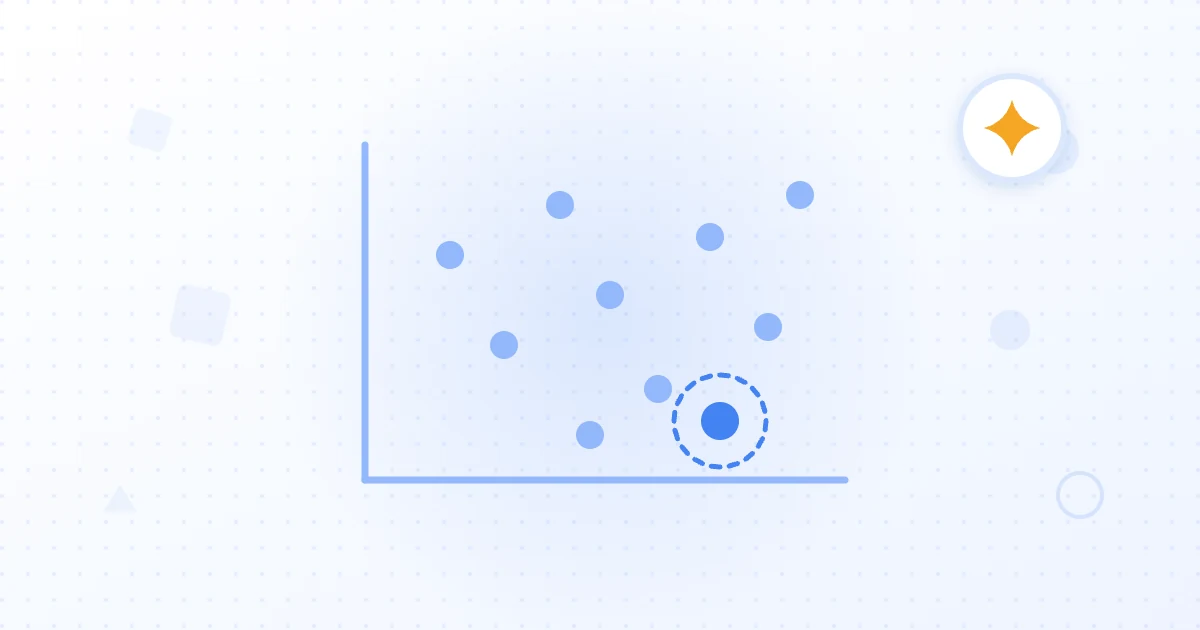
Kerneprincippet er enkelt: ens data giver ens vektorer. Ved at placere hvert element som et punkt i et fælles rum kan systemet måle, hvor relaterede to ting er, ud fra hvor tæt deres punkter ligger. Det er det, der gør, at vektorsøgning kan finde, hvad en bruger mener, og ikke kun det, brugeren præcis skrev.
Processen har tre trin. For det første omdanner en embedding-model, typisk bygget på en transformer, både de lagrede dokumenter og den indkomne forespørgsel til vektorer. Dokumenterne kodes på forhånd og gemmes. For det andet beregner systemet lighed mellem forespørgslens vektor og dokumentvektorerne ved hjælp af et afstandsmål som cosinuslighed, prikprodukt eller euklidisk afstand. For det tredje returnerer det de elementer, hvis vektorer ligger nærmest forespørgslen.
Fordi betydning er indlejret i tallene, samler beslægtede begreber sig naturligt i rummet. Ord som konge, dronning og prins ligger tæt på hinanden, mens algoritme, funktion og kode grupperer sig i en anden region. Disse embeddings skabes af modeller bygget på transformer-arkitektur, og det er det, der giver dem forståelse for kontekst.
Det er for langsomt i rigtige applikationer at sammenligne en forespørgsel med millioner af vektorer én for én. Præcis k-nærmeste-nabo-søgning er beregningsmæssigt dyr, så produktionssystemer bruger i stedet algoritmer til approximativ nærmeste nabo. De ofrer en lille smule præcision for en stor gevinst i hastighed, så et system kan søge blandt millioner af elementer på millisekunder. Almindelige metoder omfatter HNSW (hierarkiske navigerbare small world-grafer), FAISS og ANNOY.
Disse algoritmer ligger i en vektordatabase, et specialiseret system, der gemmer og indekserer embeddings til hurtig hentning og understøtter opdateringer i realtid samt de almindelige operationer oprette, læse, opdatere og slette. Databasen er det, der gør vektorsøgning praktisk i stor skala, og omdanner en smart matematisk idé til infrastruktur, der driver levende produkter.
Traditionel nøgleordssøgning bygger på leksikalsk matchning og ordfrekvens. Den er præcis, når brugeren kender det nøjagtige begreb, men den bryder sammen, når formuleringen er anderledes, eller når forespørgslen er begrebsmæssig. Vektorsøgning finder betydningsbaserede ligheder uden at kræve præcise nøgleordsmatch, så den håndterer synonymer, omskrivninger og hensigt langt bedre.
De to supplerer hinanden frem for at konkurrere. Nøgleordssøgning er god til præcise identifikatorer som produktkoder, mens vektorsøgning er god til at forstå hensigt og håndtere billeder, lyd og video. Mange moderne systemer kombinerer begge i en hybrid opsætning, og det er også sådan, semantisk søgning hos de store motorer nu fungerer.
Søgemaskiner og AI-assistenter bruger i stigende grad embeddings til at matche indhold med forespørgsler ud fra betydning og ikke blot de søgeord, der står på siden. Det flytter optimeringen væk fra at proppe præcise vendinger ind og hen imod at dække et emne klart og grundigt, så dit indhold lander tæt på de relevante forespørgsler i vektorrummet. En side, der grundigt besvarer begrebet bag en forespørgsel, kan hentes, selv om den aldrig bruger søgerens præcise ord.
For generativ motoroptimering er vektorsøgning det hentningslag, der afgør, hvilke afsnit en AI-model ser, før den skriver et svar. Hvis dit indhold ikke hentes, kan det ikke citeres. Klare, selvstændige og semantisk rige afsnit øger chancen for at blive trukket ind i den kontekst, og det understøtter direkte synligheden i AI-søgning.
Vektorsøgning er motoren bag de fleste pipelines for retrieval augmented generation. I retrieval augmented generation støtter en model sig ikke kun på det, den huskede under træningen. Den kører først en vektorsøgning for at hente relevante dokumenter og forankrer derefter sit svar i den hentede kontekst, hvilket mindsker hallucinationer og gør det muligt at citere kilder.
Det er derfor, indholdets struktur betyder så meget for AI-synligheden. Jo renere og mere fokuseret hvert afsnit er, desto mere præcist bliver det embeddet, og desto pålideligere dukker det op under hentningen. At optimere for RAG-hentning er i praksis at optimere dit indhold, så det bliver en stærk nærmeste nabo til de spørgsmål, din målgruppe stiller.
Ud over selve søgningen driver vektorsøgning anbefalingsmotorer, der foreslår lignende produkter eller artikler, spørgsmål-og-svar-systemer, der henter direkte svar fra dokumentsamlinger, og billede- eller lydsøgning, der gennemsøger ustruktureret medieindhold. Virksomheder bruger den til at navigere i store interne vidensbaser, hvor medarbejdere sjældent formulerer en forespørgsel på samme måde to gange.
Det samlende tema er opdagelse uden præcis terminologi. Brugere kan søge efter begreb frem for præcise ord, hvilket er værdifuldt, når folk ikke kender eller er uenige om det rigtige søgeord. Kombineret med stærkt indhold og velovervejet søgeordsanalyse og indholdsplanlægning hjælper det dig med at dække de begreber, disse systemer henter efter.
Vektorsøgning er ikke gratis. At generere embeddings, lagre vektorer med mange dimensioner og køre lighedssøgning i stor skala kræver regnekraft og hukommelse, og approximative algoritmer bytter en del præcision for hastigheden. Kvaliteten af resultaterne afhænger også helt af embedding-modellen: en model, der fanger dit domæne dårligt, vil samle de forkerte ting.
Der er også blinde vinkler. Ren vektorsøgning kan overse præcise match, som nøgleordssøgning ville fange, for eksempel et bestemt reservedelsnummer, og det er grunden til, at hybride tilgange findes. Og fordi rummet er uigennemsigtigt, er det sværere at finde ud af, hvorfor et bestemt resultat rangerede, hvor det gjorde, end at undersøge et nøgleordsmatch. At behandle vektorsøgning som ét værktøj i en bredere hentningsstak, frem for et mirakelmiddel, giver de bedste resultater.
Vektorsøgning henter information ud fra betydning. Den omdanner indhold og forespørgsler til embeddings og rangerer resultaterne efter, hvor tæt de ligger i et fælles rum. Den ligger til grund for semantisk søgning, anbefalinger og hentningstrinnet i moderne AI-svar. For marketingfolk og udgivere flytter den optimeringen mod at dække begreber klart, så dit indhold lander tæt på de forespørgsler, der betyder noget, og bliver trukket ind i AI-svar.
For at gå videre skal du koble dette til embeddings og semantisk søgning, og bruge Soranks værktøjer til research og indholdsplanlægning til at dække de begreber, disse systemer henter efter. Kilder: Elastic og Weaviate.
Kilder

Nøgleordssøgning matcher de præcise ord i en forespørgsel mod ordene på en side, så den fejler, når formuleringen er anderledes. Vektorsøgning omdanner både forespørgslen og indholdet til numeriske embeddings og rangerer resultaterne efter semantisk nærhed, så den finder relevante resultater, selv uden fælles nøgleord. Mange systemer kombinerer begge i en hybrid tilgang for at få præcise match og betydningsbaserede match samlet.
Embeddings er de numeriske repræsentationer, der gør vektorsøgning mulig. En embedding-model, typisk baseret på en transformer, omdanner tekst, billeder eller lyd til en række tal, der fanger betydning og kontekst. Elementer med ens betydning ender med ens vektorer, så systemet kan rangere resultaterne efter, hvor tæt deres embeddings ligger i det fælles rum.
Vektorsøgning er det hentningslag, AI-assistenter bruger til at finde relevante afsnit, før de skriver et svar. Hvis dit indhold ikke hentes, kan det ikke citeres. Klare, selvstændige og semantisk rige afsnit hjælper dine sider med at lande tæt på de rette forespørgsler i vektorrummet, og det øger chancen for, at de trækkes ind i et AI-svar og refereres.
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer


















